演播室主播
明亮的演播室构图、眼神看向镜头——口播公告或产品演示的默认观感。
让一张静态照片化身唇形同步的口播数字人,念出任意台词。
把一张清晰的正面人像拖进 Renoise Canvas,在提示词里写下要念的台词,然后用 Kling 3.0 Omni 渲染。它会按台词自己生成声音,并让嘴部和面部同步开口,把静态照片变成会说话的数字人。想让照片念你自己的录音,就把人像和录音一起交给 Renoise Agent,由 Wan 3.0 来做。如果是真人,必须是你拥有肖像授权的面孔。
本指南面向唇形同步的口播数字人。如果只想让照片产生没有对白的常规动态,请查看 AI 照片转视频工具页
在 Renoise 里用三步把一张人像变成唇形同步的口播数字人。
把一张清晰的正面人像拖进 Canvas。如果是真人,必须是你拥有肖像授权的面孔。
在提示词里写下要念的台词——Kling 3.0 Omni 会按这段文字生成声音,并让口型跟着走。
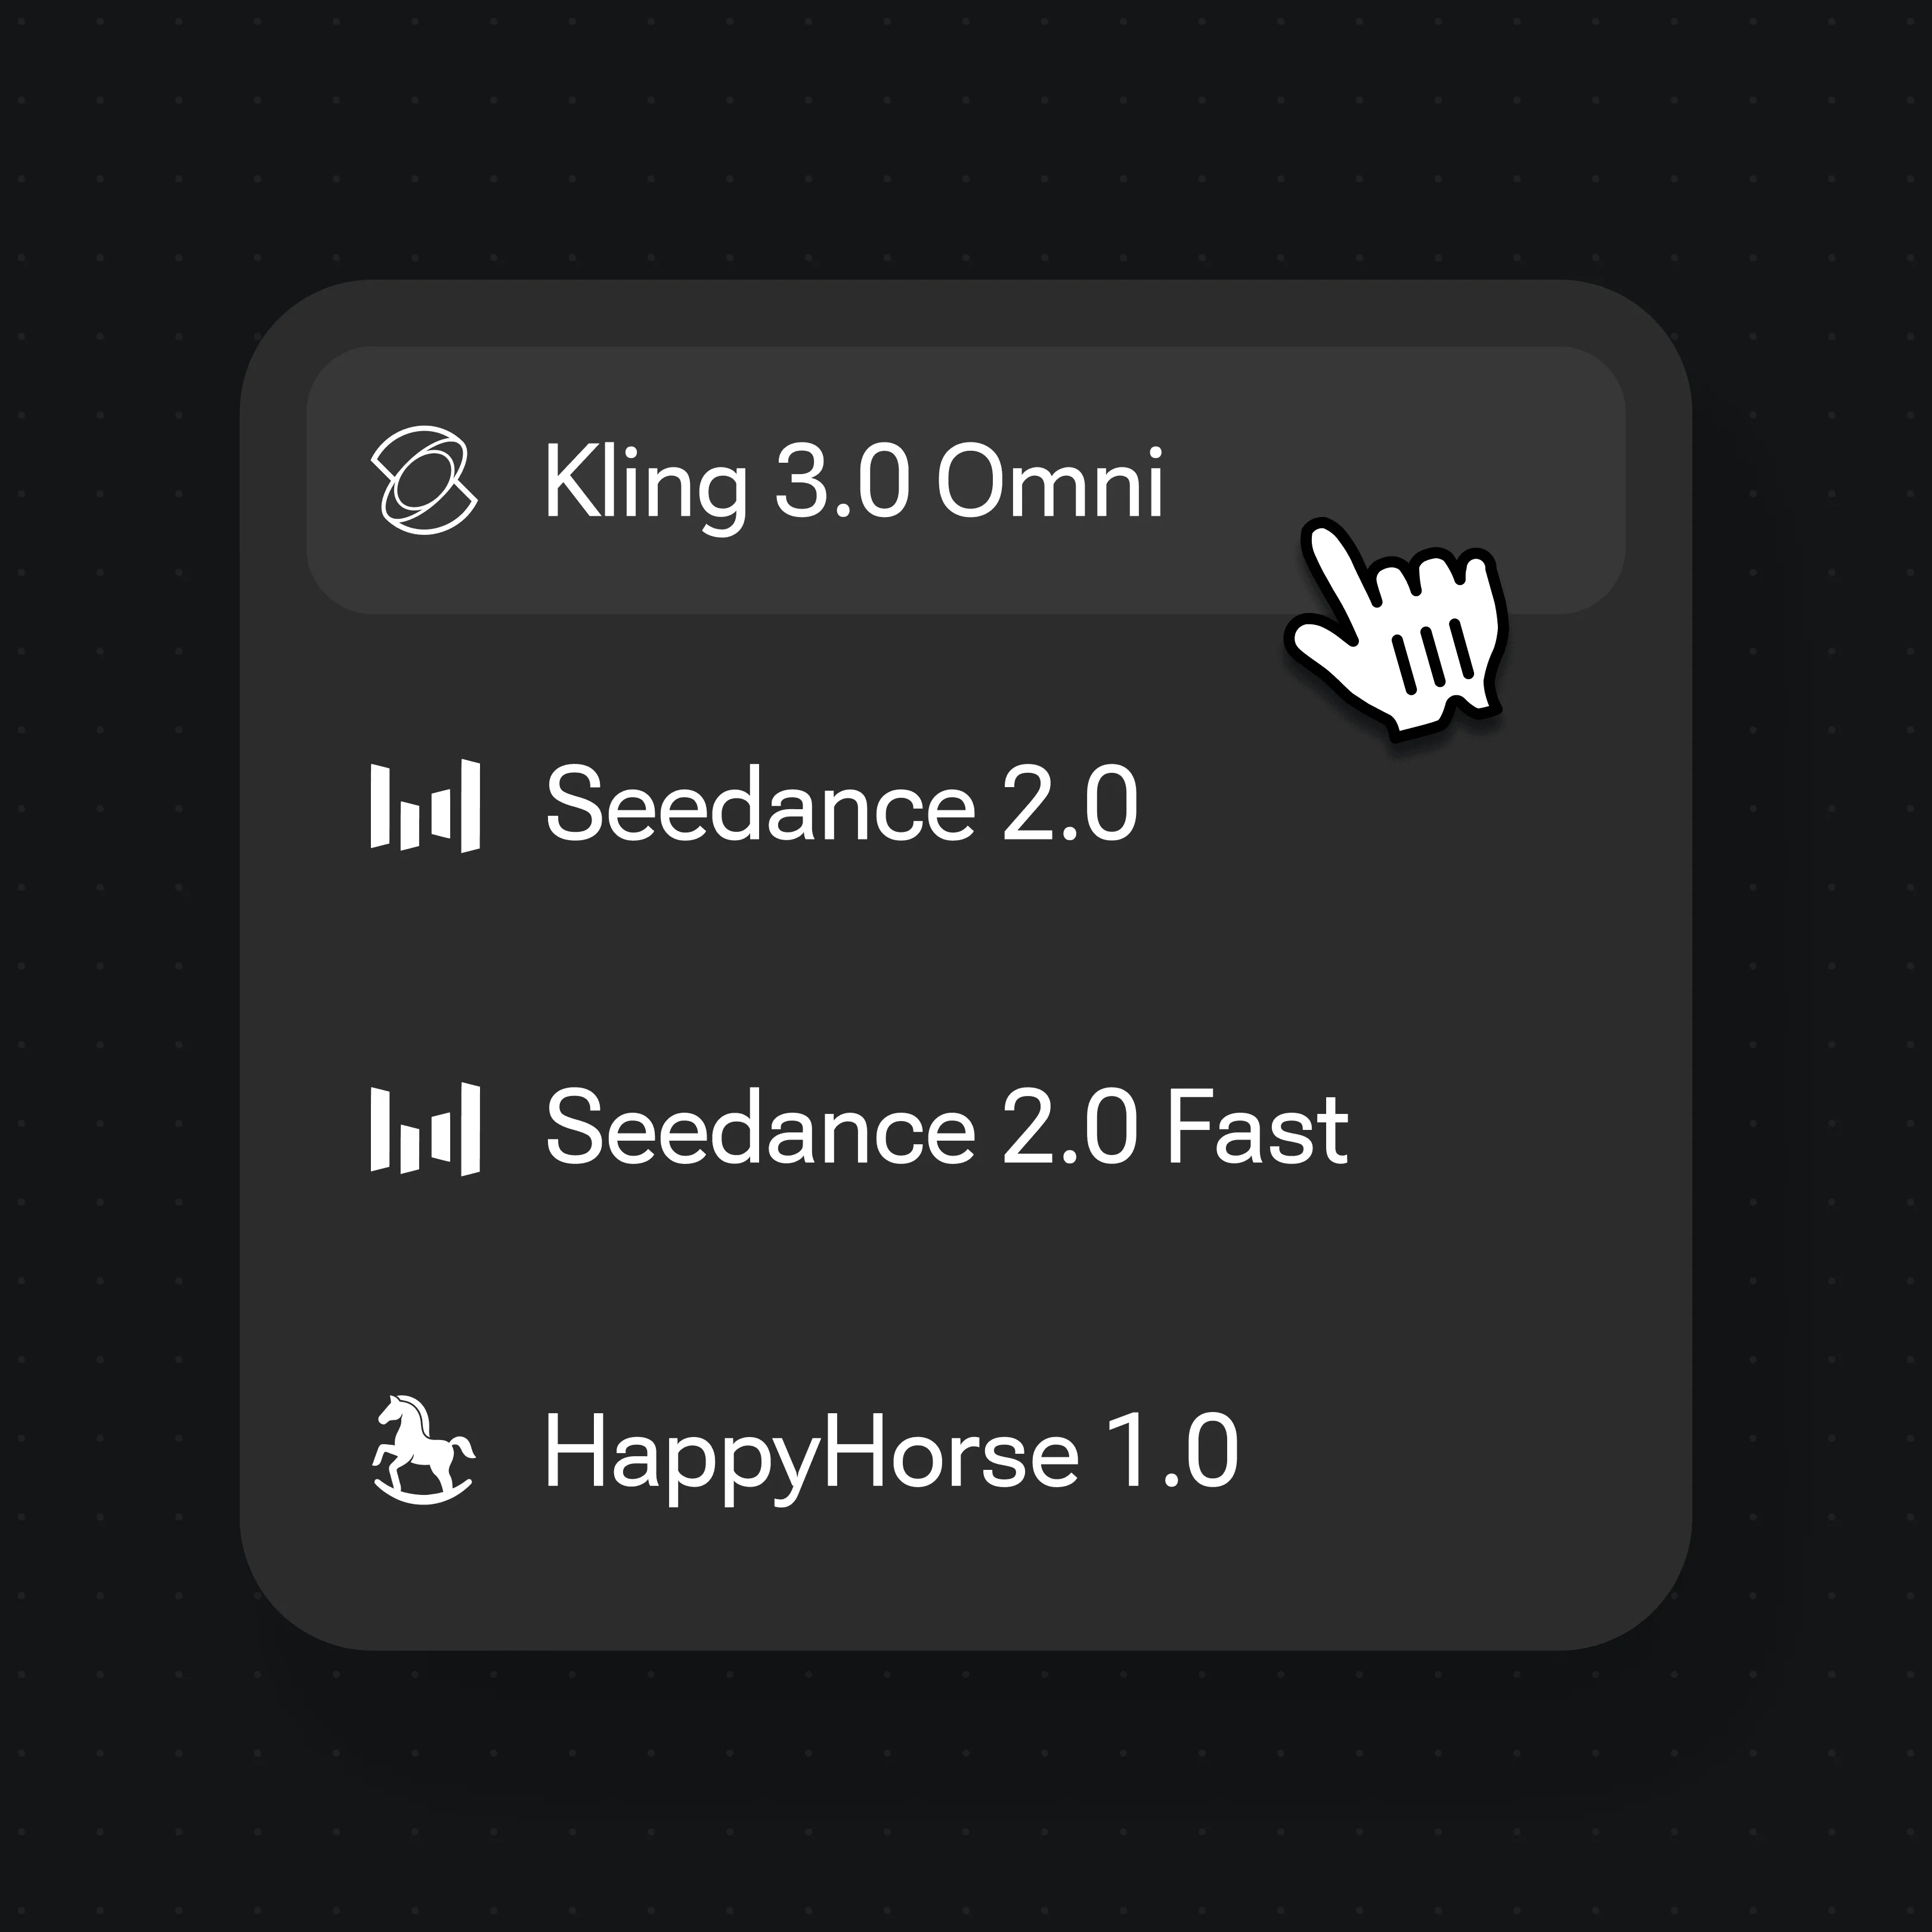
在模型菜单里选择 Kling 3.0 Omni 以启用原生唇形同步,然后渲染口播片段。
用 Renoise 制作的主播风格片段——正是会说话的照片切到的那种构图。
明亮的演播室构图、眼神看向镜头——口播公告或产品演示的默认观感。
一张安静的户外人像,主角直视前方——传递真诚口播信息的自然构图。
人物稳稳立于繁忙街道之前——出外景口播片段的记者式布置。
一张自信的户外人像衬以干净墙面——适合做主持人开场或发言人数字人。
会说话的照片和完整 AI 视频不是一回事。常规的文生视频片段会凭一段提示词凭空生成动作、运镜和整个场景。而会说话的照片从你提供的一张静态人像出发,只加上一样东西:由音频驱动的嘴部和面部。画面、身份和构图都锚定在你的照片上,只有说话这一部分在动。正因如此,它看起来还是同一个人,而不是一次全新生成。
唇形同步是把语音映射到口型的技术。每一个音素——单词中各不相同的发音——都对应一个视位,也就是观众预期看到的口型。模型逐帧把它们对齐,让嘴唇、下巴和脸颊跟着说出的每个音走。
在 Renoise 里,Kling 3.0 Omni 原生处理这一切——无需另外加挂一道唇形同步流程。你拖入人像、写好台词,模型自己配音,一步就渲染出口播片段。它不接收上传的音频;如果想让照片念你自己的录音,就把人像和录音交给 Renoise Agent:它用 Wan 3.0 逐段让口型跟着录音走,再把各段拼成和录音一样长的视频,默认 720p。如果用的是真人照片,只限你拥有肖像授权的面孔——你本人,或已取得书面同意的人。
会说话的照片依赖几项能力——而 Renoise 在一块画布里同时给你 Kling 3.0 Omni 和其它众多视频模型。
用你拥有肖像授权的真人照片——你本人,或已取得书面同意的人——做成会说话的数字人。
原生唇形同步按你写的台词生成声音,并驱动嘴部和面部——无需另装唇形同步工具。
输入文字让数字人念出来,支持多种口语语言;要用自己的录音,就交给 Renoise Agent,由 Wan 3.0 对口型。
逐段在 Kling 3.0 Omni 和其它视频模型之间切换——全在同一个项目里。
一个套餐即可解锁 Kling 3.0 Omni 和其它所有视频模型。
适合初次尝试 AI 创作
按月计费
≈ 150 次 GPT Image 2 生成
≈ 60 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合每周持续创作
按月计费
≈ 450 次 GPT Image 2 生成
≈ 180 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
Renoise Agent 使用头部 AI 实验室的前沿模型规划镜头、写提示词,并为每个镜头选合适的模型。所有套餐下,和 Agent 聊天都不扣积分。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合专业规模产出
按月计费
≈ 1,750 次 GPT Image 2 生成
≈ 700 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
Renoise Agent 使用头部 AI 实验室的前沿模型规划镜头、写提示词,并为每个镜头选合适的模型。所有套餐下,和 Agent 聊天都不扣积分。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合初次尝试 AI 创作
每月,按年计费
节省 $48(相比月付)
≈ 150 次 GPT Image 2 生成
≈ 60 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合每周持续创作
每月,按年计费
节省 $216(相比月付)
≈ 450 次 GPT Image 2 生成
≈ 180 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
Renoise Agent 使用头部 AI 实验室的前沿模型规划镜头、写提示词,并为每个镜头选合适的模型。所有套餐下,和 Agent 聊天都不扣积分。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
适合专业规模产出
每月,按年计费
节省 $960(相比月付)
≈ 1,750 次 GPT Image 2 生成
≈ 700 条 Seedance 2.0 视频
Agent 从想法一路帮你做到成片
Starter 和 Standard:Director Mode 的制作按用量扣积分;Advanced 免费。
无需排队。可同时启动任意数量的付费生成任务。
Renoise Agent 使用头部 AI 实验室的前沿模型规划镜头、写提示词,并为每个镜头选合适的模型。所有套餐下,和 Agent 聊天都不扣积分。
使用 Renoise.ai 生成的内容可用于商业用途,但须遵守我们的服务条款
把一张清晰的正面人像拖进 Renoise Canvas,在提示词里写下要念的台词,然后用 Kling 3.0 Omni 渲染。它会按台词生成声音,并让嘴部和面部同步开口,把静态照片变成会说话的数字人。
当你想让照片配着同步音频说话时,用这个流程。如果只想要常规动态——运镜、主角转身或走动、没有对白——那属于照片动画,请改用我们的 /features/photo-to-video-ai 照片转视频工具页。
可以,但只限你拥有肖像授权的面孔,例如你本人,或已取得书面同意的人;面孔仍可能被拒绝。不得使用名人、公众人物和未成年人,并须遵守当地法律。
不行。名人和公众人物都不允许使用。请改用你自己的照片、已取得书面同意的对象,或一张完全原创的 AI 生成人脸。
可以,但不是用 Kling 3.0 Omni——它不接收上传的音频,只会按你写的台词自己生成声音。要让照片念你自己的录音,就把一张人像和这段录音(说话或唱歌都行)交给 Renoise Agent,Wan 3.0 会以每段最长 15 秒让嘴部跟着录音走,再拼接成和录音一样长的视频,默认 720p。
Kling 3.0 Omni 支持多种口语语言的唇形同步。用目标语言写下台词,它会用这种语言念出来,嘴部动作跟着发音走。
Kling 3.0 Omni 每段片段上限为 15 秒;走 Renoise Agent 用自己的录音时,视频和录音一样长,不限时长。生成的视频片段可直接在 Renoise 中编辑和裁剪。